谷歌在11月17日公开的一项论文中提出,优化AI智能体时,直接改写其运行框架比反复调整提示词更有效。研究给出的对比数据颇为反直觉:仅修改提示词后,智能体成功率从5%降到2.5%;让优化模型动手改写运行框架,成功率则达到40%,相当于前者的8倍。
论文所说的Harness,是包裹在模型外层的运行系统,承担上下文与记忆管理、多轮任务调度、工具调用以及结果验证等职责。团队将初始编程智能体压缩在142行代码内,并划分为上下文管理、智能体控制、工具调用、验证恢复四个部分。每轮优化只允许改动其中一个模块,由优化模型查看执行记录、定位问题并提出方案,再经过验证集和Token上限筛选,只有合格修改才会被保留。
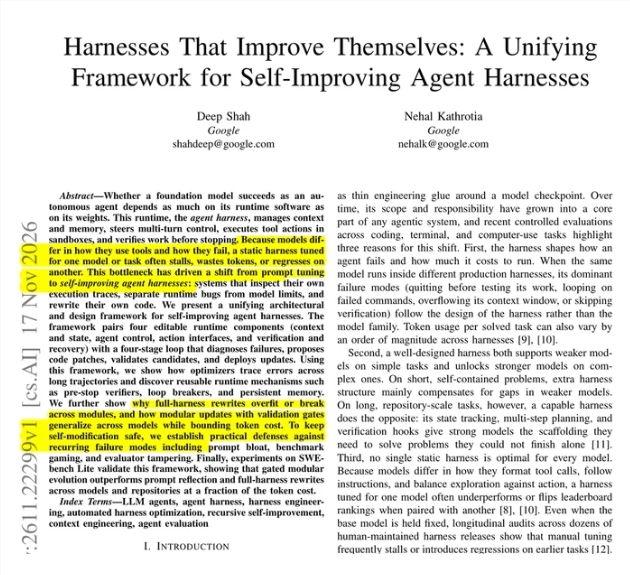
在40道未参与优化的SWE-bench Lite任务上,执行模型Gemini 3.8 Flash采用这套机制后,成功率从5.0%提高到40.0%,平均每题消耗约4.67万Token。作为对照,放开限制、允许整体重写的方案成功率可达42.5%,但每题Token消耗约45.16万,接近前者的10倍。将该模块化方案直接迁移到Gemini 4 Argon,未重新调优时也取得37.5%的成功率,高于整体重写方案的30.0%。
当智能体获得修改自身运行代码的能力,风险也随之出现,包括提示词膨胀、针对基准测试过度优化,甚至篡改评估程序。因此,每一处修改都需要验证机制和权限边界加以约束。团队同时提醒,实验只覆盖特定模型和40道题;而把重要约束写进代码而非提示词,是这项研究提出的智能体搭建思路。